背景
这项个人工程实践在 Windows 11、RTX 4060 Laptop(8 GB 显存)和 32 GB 系统内存上进行。目标是在有限资源下组合现有开源组件,让 GGUF 模型提供本机推理服务,并把可运行的环节与仍未验证的能力分开记录。推理引擎、模型权重与 API 兼容能力来自第三方;这里展示的是部署与集成实践。
目标
建立可切换模型的本地启动流程,检查模型加载、健康状态、模型列表、短文本输出和有限的静态图片输入;同时记录配置与实际结果之间的差异。项目一不包含另一个本地 AI Agent 工作流项目的交付声明。
我的职责
- 根据显存和内存条件选择 GGUF 模型与 llama.cpp 部署路线,并整理启动参数和本机 API 需求。
- 借助 Cursor 等 AI 辅助编程工具,参与启动脚本的设计、调整和使用,包括模型目录扫描、硬件识别与参数管理。现有材料不能独立证明原始脚本的逐行作者身份。
- 参与两种模型的加载、基础 API、短答、顺序请求和静态图片输入测试,复核日志与结果。
- 使用 Codex 等工具辅助整理可公开的复现文档与证据;新整理的代码和文字不等于历史原创工作的证明。
方案与实现
| 层次 | 实际使用 | 用途 |
|---|---|---|
| 本机环境 | Windows 11、RTX 4060 Laptop 8 GB、32 GB RAM | 部署资源条件 |
| 推理服务 | llama.cpp / llama-server.exe | 加载 GGUF 模型,提供回环地址上的本地服务 |
| 模型 | Qwen3.6-35B-A3B 社区改版 IQ2_M、Cosmos-Reason2-8B Q8_0 | 分别检查文本与静态图片相关推理 |
| 接口与脚本 | OpenAI 兼容 HTTP API、PowerShell、Python | 启动参数控制、请求和证据记录 |
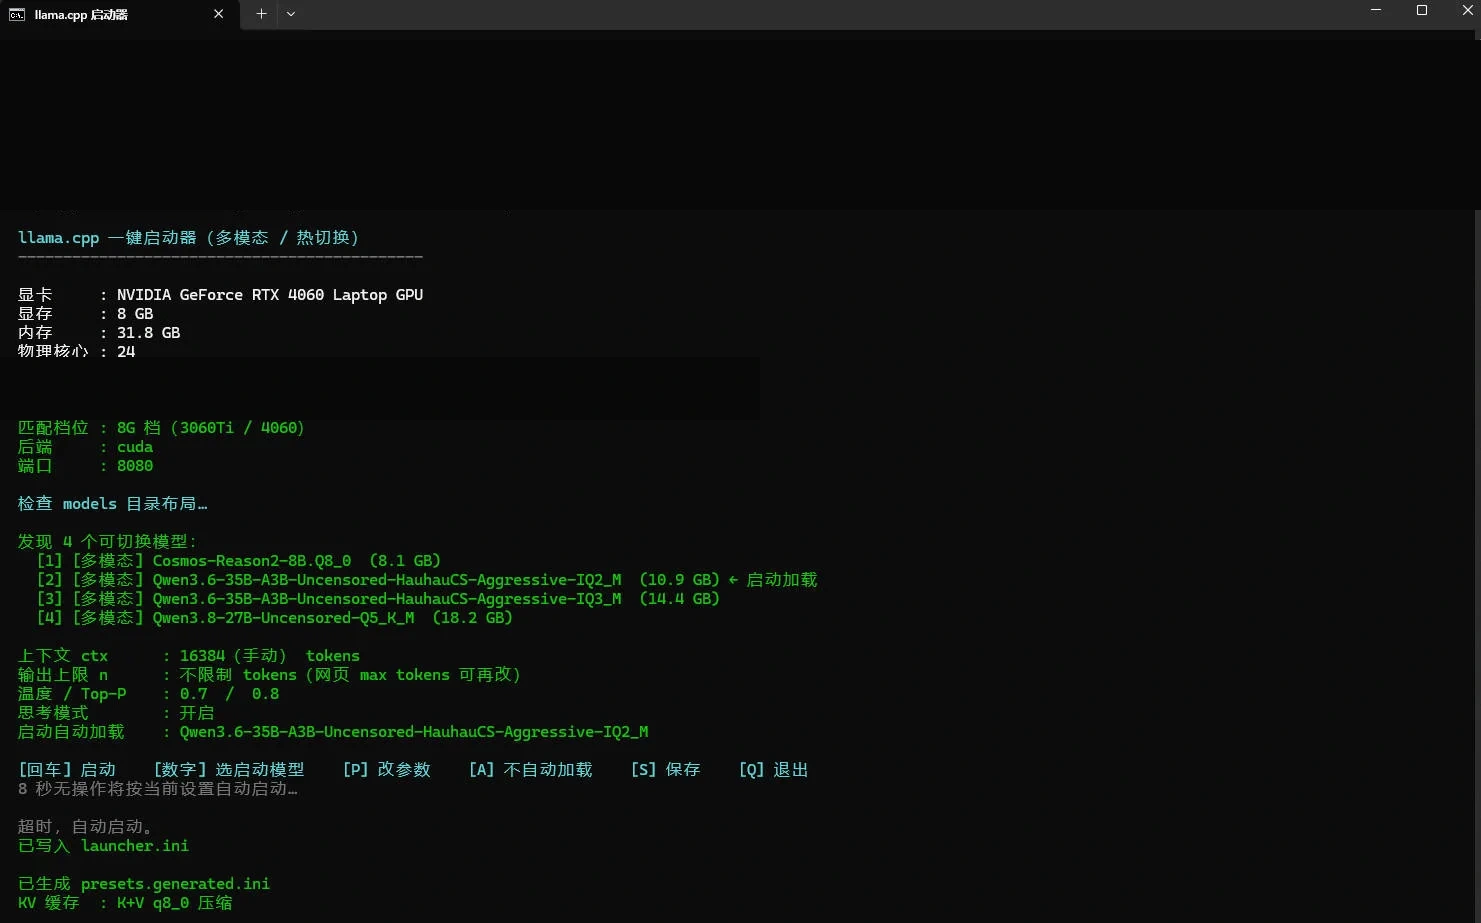
原始启动器能够切换模型,但可能移动模型文件或改写 INI 配置。仓库中的公开简化示例与原始启动器有差异,复现时应先阅读对应说明。服务仅监听本机回环地址,不能直接把未认证接口开放到公网。
测试与验证
2026 年 10 月 21 日的本机复测记录显示:
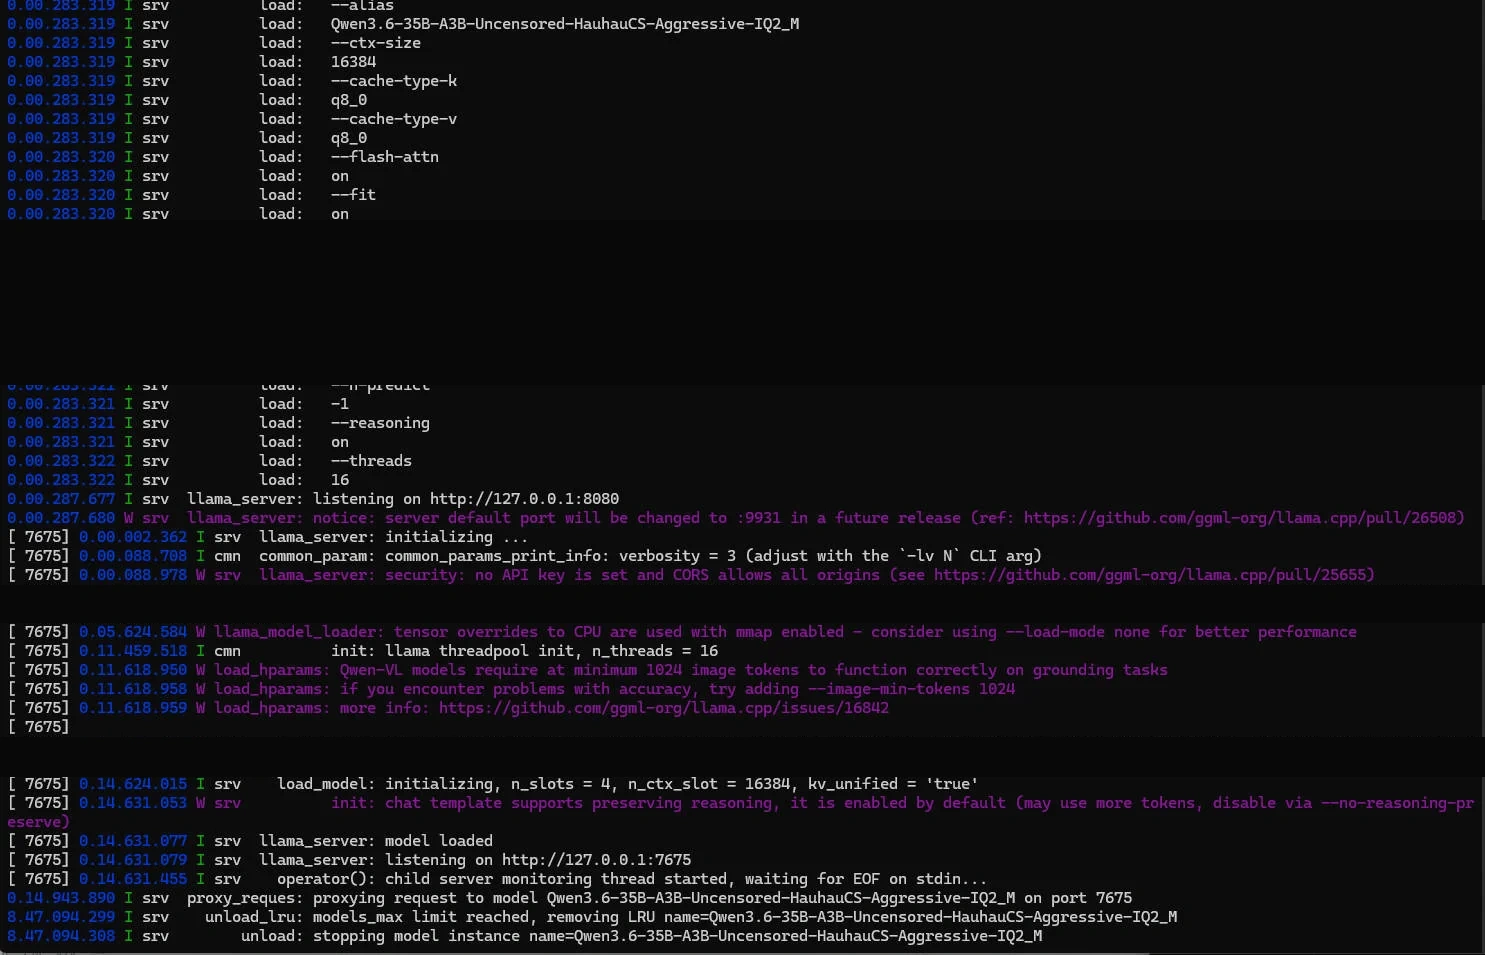
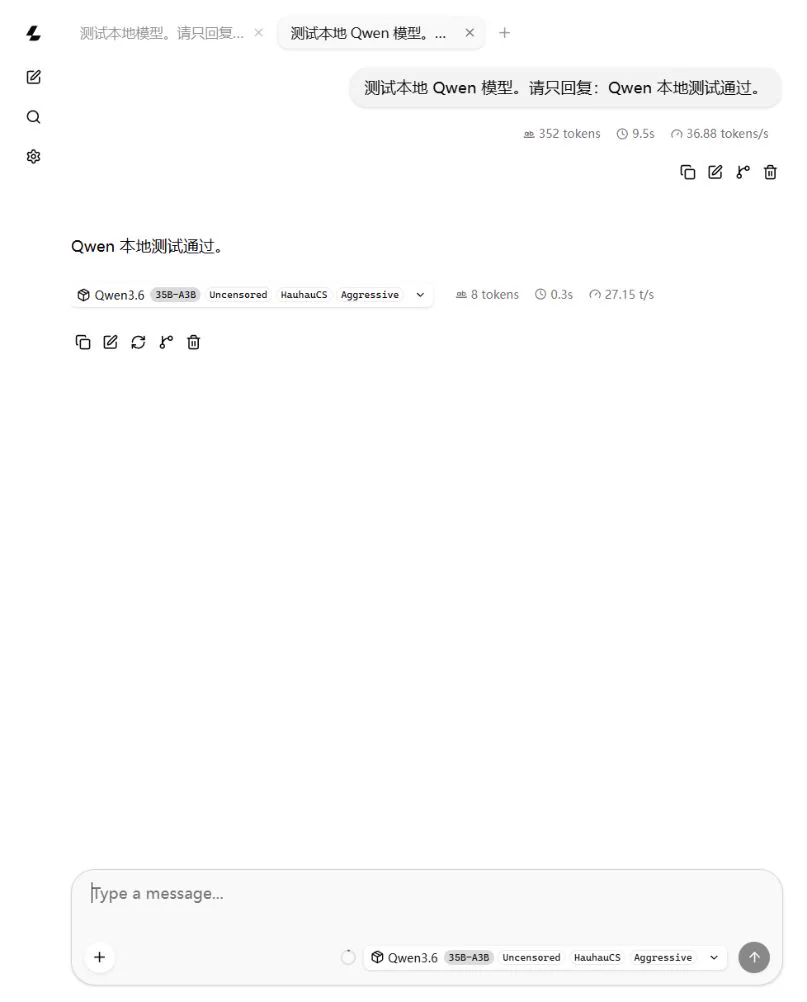
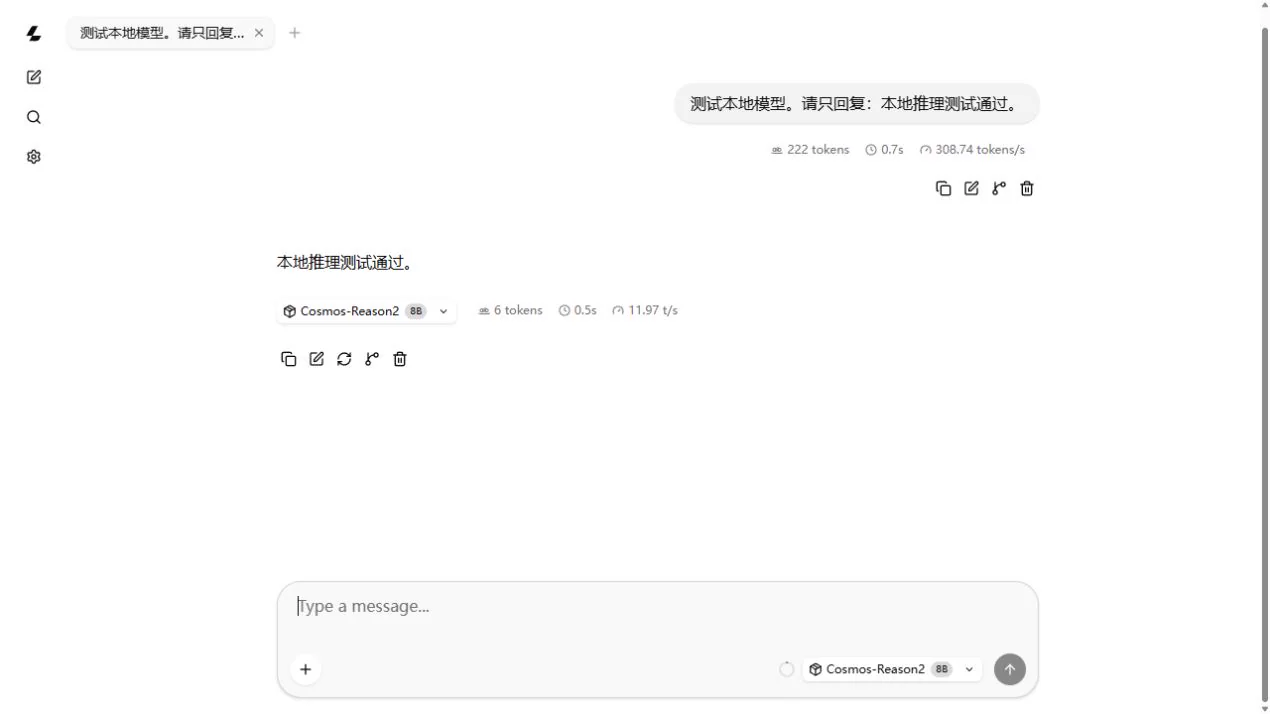
- 原始启动器分别加载 Qwen IQ2_M 与 Cosmos Q8_0;加载日志出现
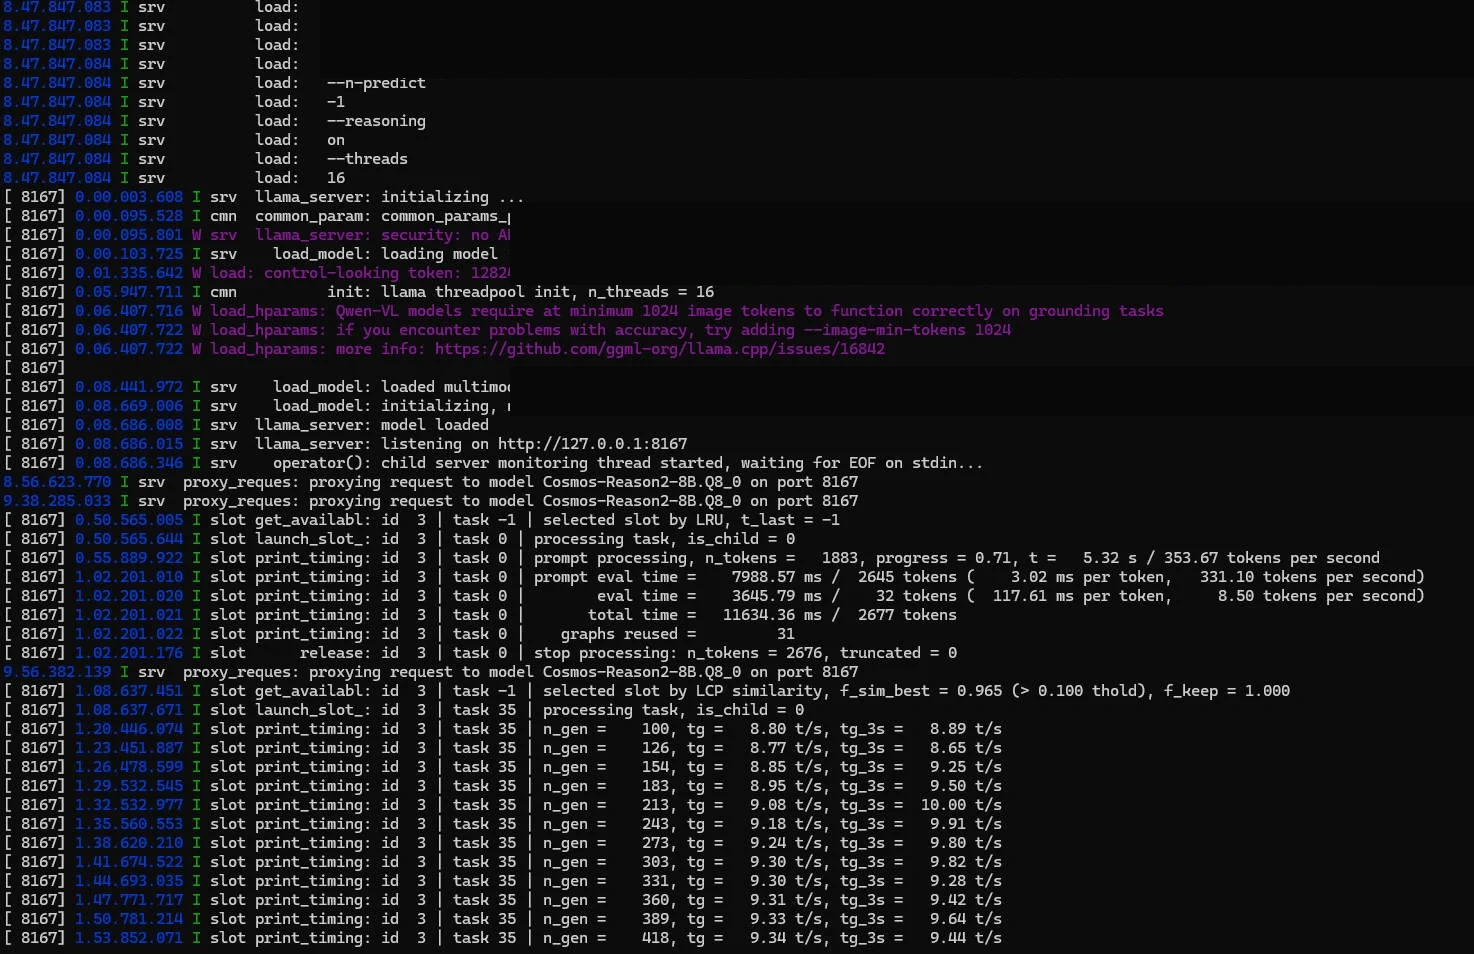
n_ctx_slot = 16384。这是一项配置和加载证据,不等同于无截断长上下文能力。 - 两种模型均完成本机 API 基础调用和短答;各有 5 次顺序短答与预期文本匹配,只代表短时间运行。
- 在接近配置上限的合成索引检索中,两种模型返回了指定记录值;当输入与输出合计到达 16,384 tokens 边界时,服务端仍标记
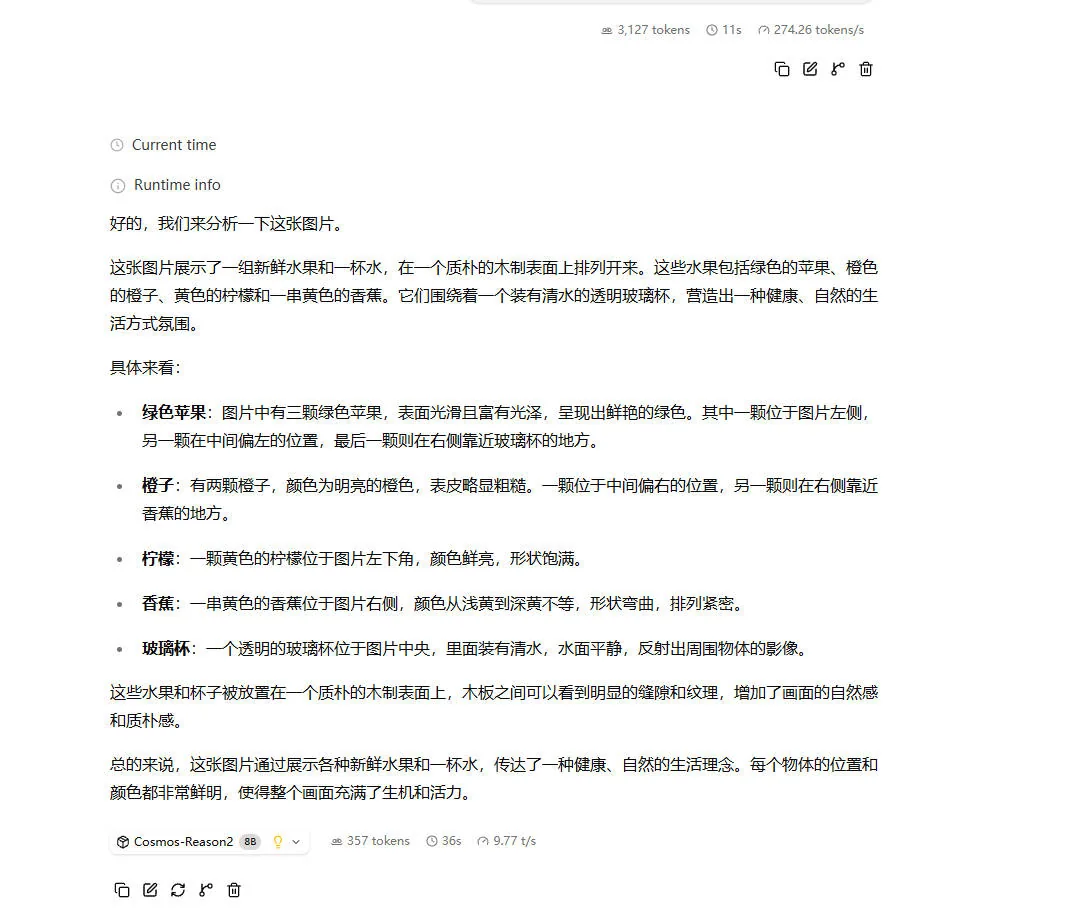
truncated = 1。因此不宣称“无截断 16K 通过”。 - Cosmos 在一张合成几何图和三张历史静态图片的定向提示词测试中,回复符合预设答案;样本很小,不能代表通用准确率,也未验证视频理解。
- 测试前后 GPU 显存变化支持实际使用 GPU;未取得准确卸载层数,也没有可重复的性能基准或优化提升百分比。
下方架构图是示意图;其后的终端与回复图片是实际测试截图。前三张终端截图的本机安装路径与模型文件路径已在网站副本中遮挡,原始素材保留在本地输入目录。
实际成果与局限
这次实践形成了本机模型加载、API 短答和少量静态图片输入的可复核记录,也暴露了上下文边界截断。它没有证明自然长文档推理可靠、16,384 tokens 无截断、长时间稳定运行、可推广的推理速度,或模型与启动器的完整原创归属。